例 1 · 查到出处
输入「喜伤心」 · 设置:英语 / 古典 / 公众
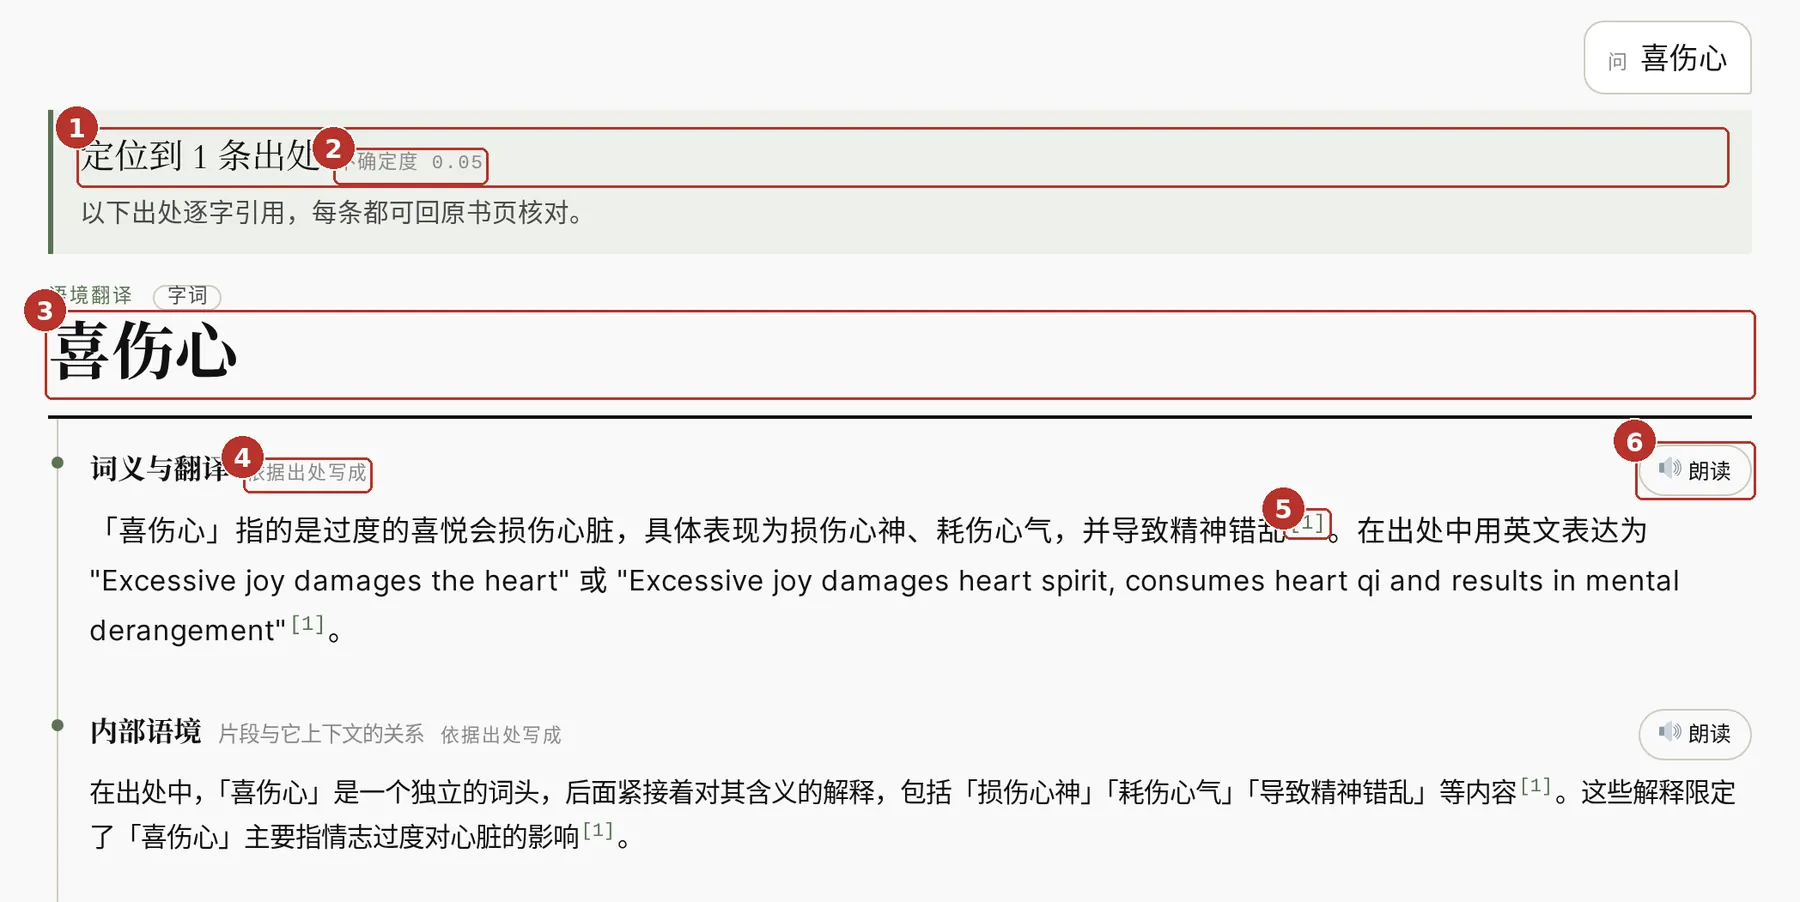
输出 定位到 1 条出处(WHO-IST-TCM-2022 p.40,不确定度 0.05)。英文:Excessive joy damages the heart。解读:「过度的喜悦会损伤心脏,具体表现为损伤心神、耗伤心气,并导致精神错乱 [1]」。
DOORM · 重返东方第一桥语境翻译器
给研究者、专业译者、院校与医学文化机构:先定位出处,再谈翻译;付费买的是可追溯术语报告与批量检索,不是又一个机器翻译。
给它一个字词、一句话或一段原文,它先定位到出处,再解释这个片段本身:它是什么意思、各语种怎么译;内部语境——它和上下文的关系;外部语境——片段之外的语言环境,哪些语种、哪个医学体系、哪一类书在用它;以及它用在什么场境。定位不到就明说定位不到,并告诉你补哪一句就能接着查。
条记录,每条带来源与许可;受版权保护的典籍层只在内网
中医 · 阿育吠陀 · 尤那尼 · 悉达 · 西太区传统医学
印 泰 越 日 韩 马来 菲 孟 乌尔都 藏 蒙 维 …
每次回答封入哈希链,四项判据逐条核对
最后两个按钮是故意会失败的——请点它们。打字、说话、拍一页书都可以问。
覆盖范围:本翻译器覆盖民族医学以外的东方文化多语种语境(文学、哲学、艺术、礼仪、历史等);民族医学术语与方名也可查,但不限于医学。
查不到时:若方名不在库中,会如实显示「库中暂无该方出处」。
第一次用?先看使用说明书 ↓只收文献书页。画面里有人(面部、皮肤、舌象一类)会被当场拒收——不是做不了,是刻意不做。问题文字、语音提问的录音和通过筛查的书页,会交给Genmount 模型服务处理(归纳检索词、转写、生成解读与朗读),其中中文语音由设在中国大陆的语音识别服务转写;我们这边不保存录音和图片,图片只留一个指纹用于审计。
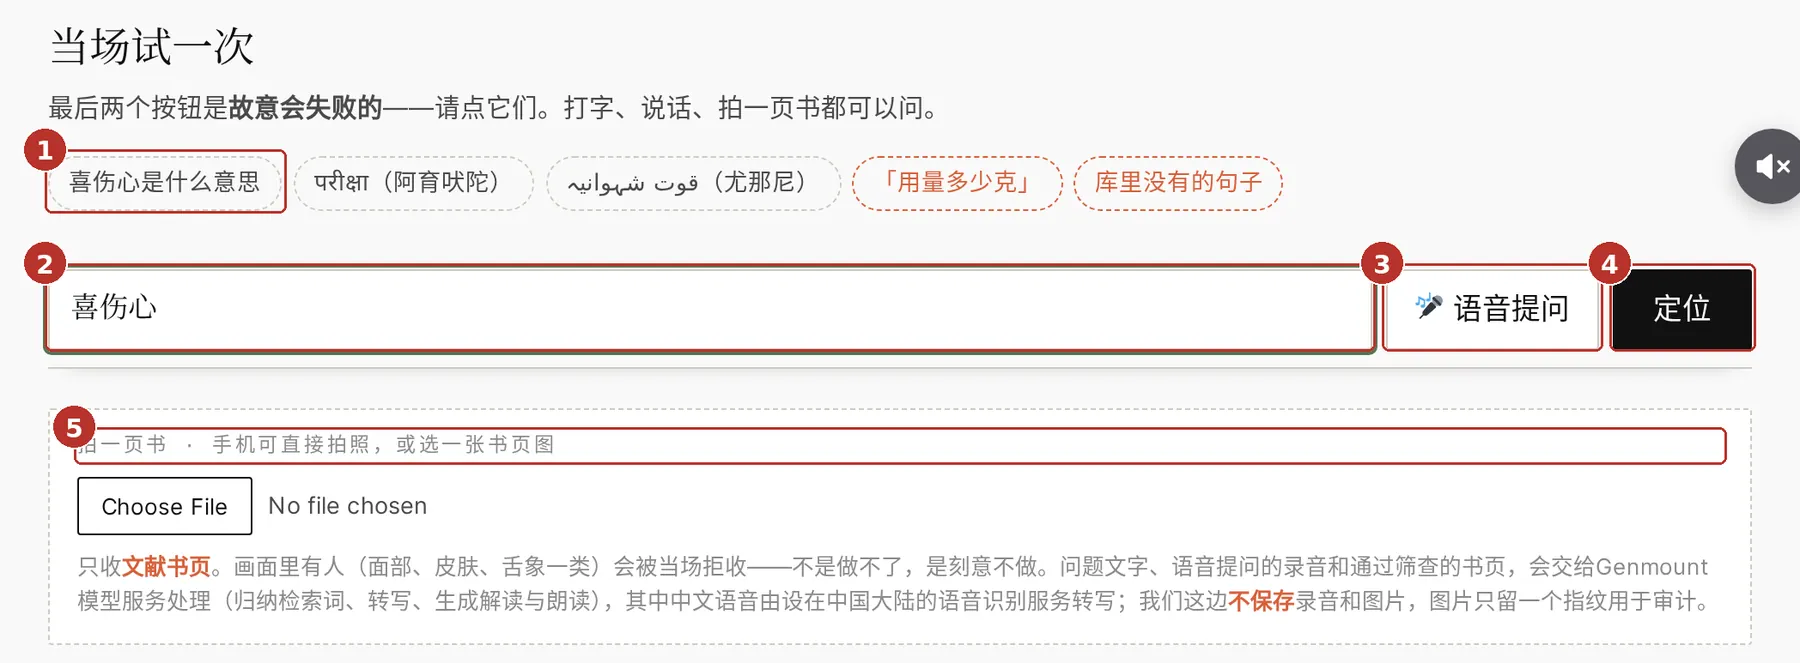
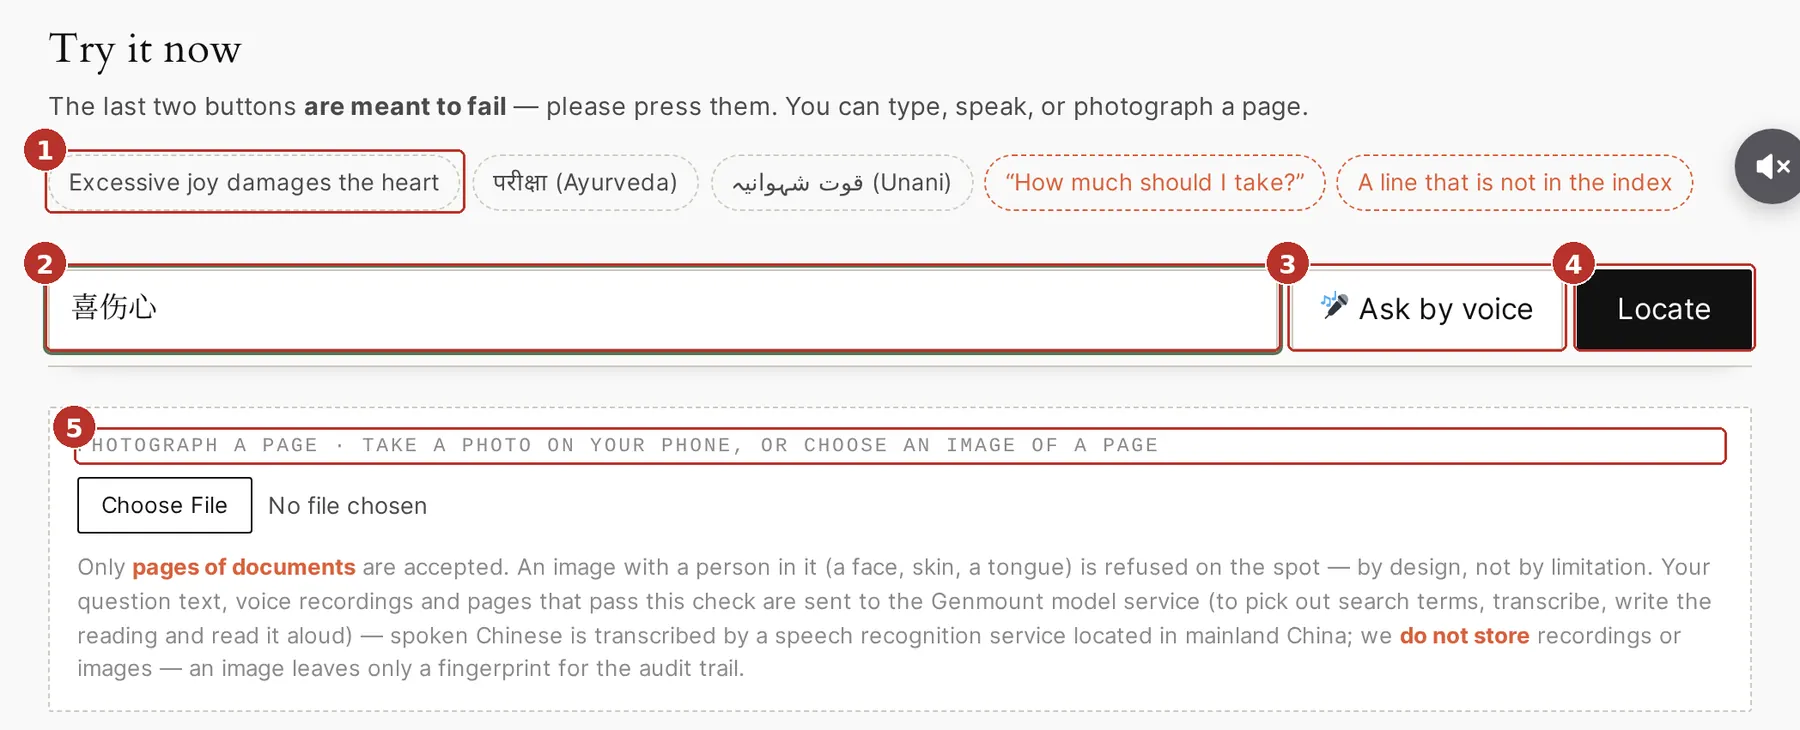
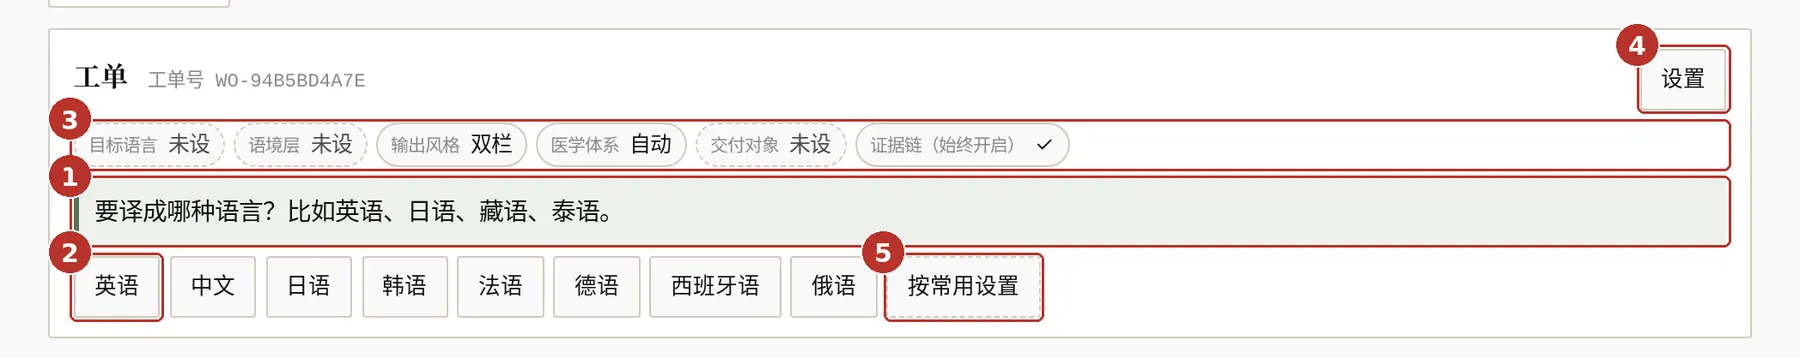
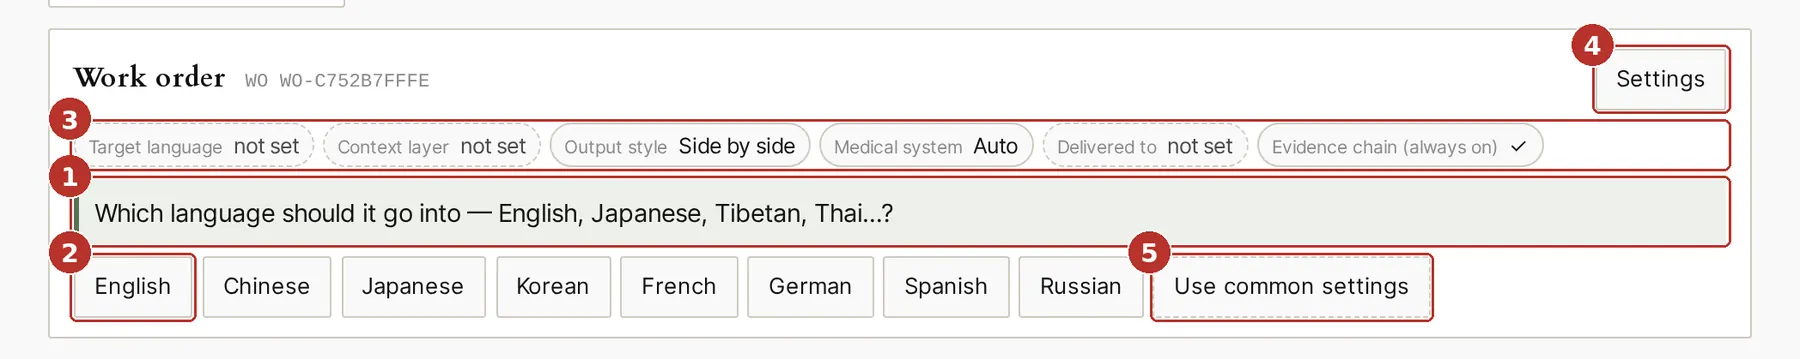
下面每张图都是本页翻译器的真实截图,图上的红色编号与文字里的同号说明一一对应。
覆盖范围:除民族医学术语与方名外,本翻译器还覆盖东方文化的多语种语境——文学、哲学、艺术、礼仪、历史等;查不到依旧明说。
① 点一个示例按钮,马上试;② 或在输入框里写一个字词、一句话或一段原文,例如「喜伤心」;③ 点「语音提问」直接说;④ 点「定位」开始;⑤ 也可以拍一页书或选一张书页图——只收文献书页,画面里有人会被拒收。
点「定位」后会出现一张工单。① 数字人用一句话问你还缺什么;② 点选目标语言(英语、日语、韩语、法语……),接着它会依次问语境层(古典 / 口语 / 大众 / 学术 / 临床描述)和交付对象(公众 / 内容团队 / 研究者 / 临床仅描述),各点一个即可;③ 这一行是当前设置,虚线框 = 还没设;④「设置」可随时改;⑤ 不想逐项选,点「按常用设置」。
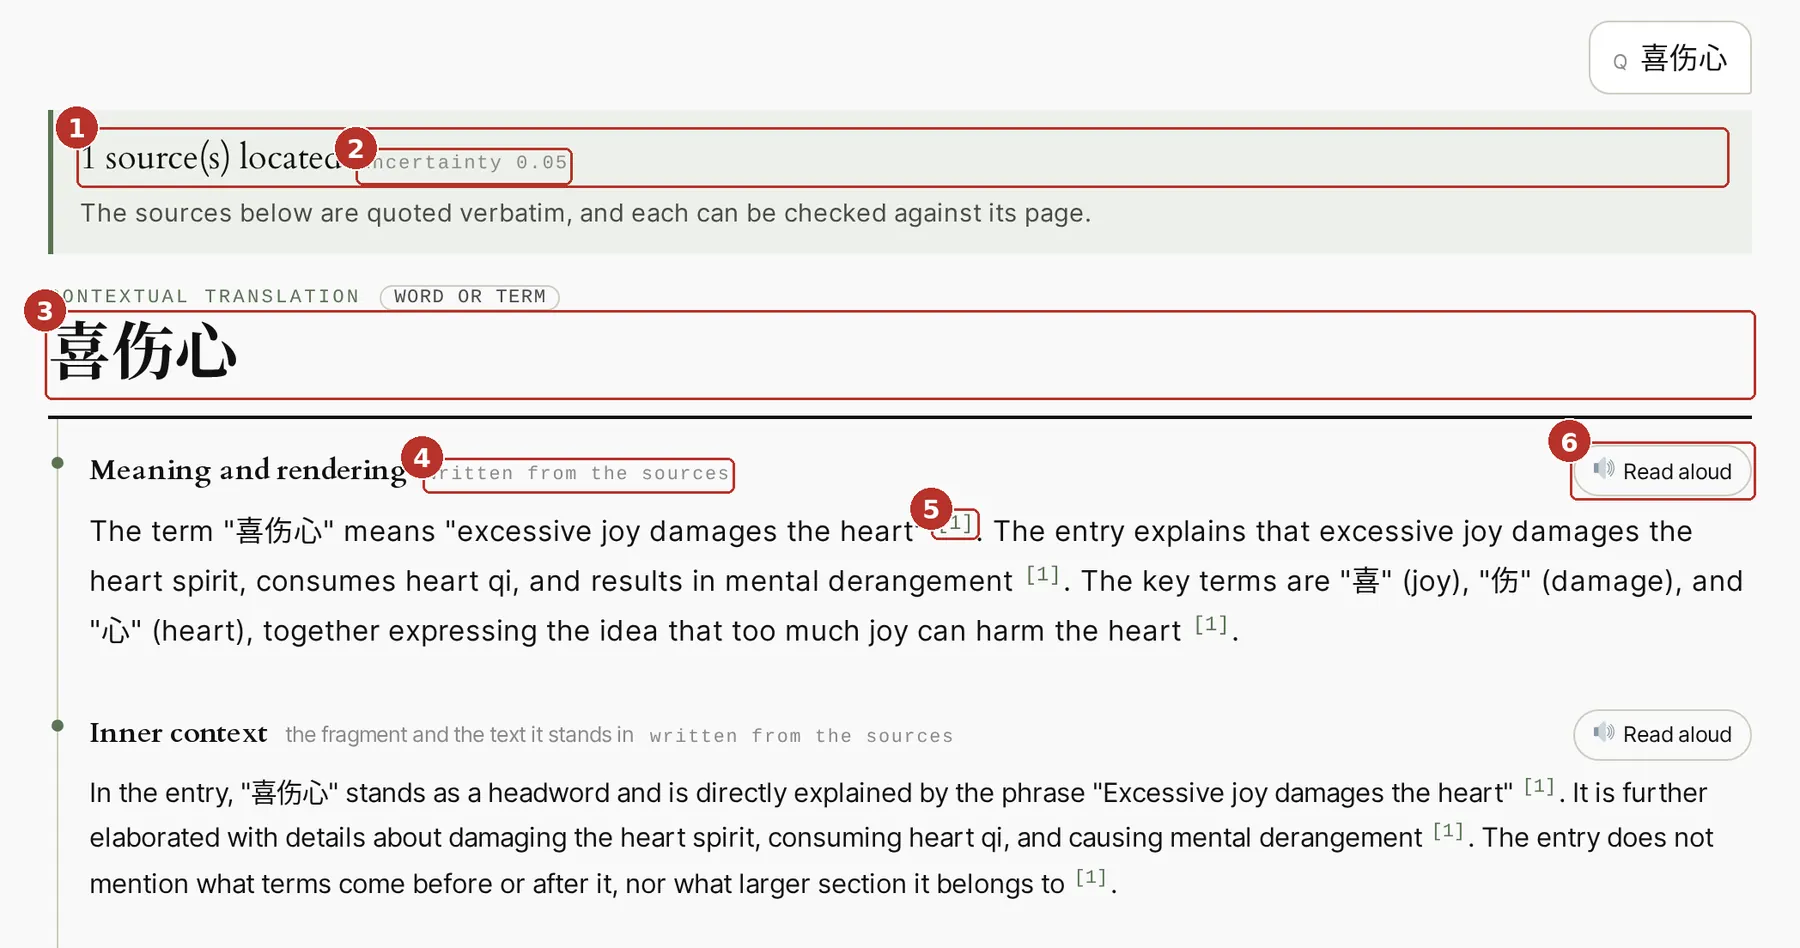
① 先看结论:定位到几条出处(定位不到会明说);② 不确定度,越小越稳;③ 你查的片段;④ 每段都注明「依据出处写成」;⑤ 句末的 [1] 编号对应下方出处;⑥ 每段都能「朗读」。结果分四段:词义与翻译 · 内部语境 · 外部语境 · 应用场境,外部语境里还有一张图,标出这条出处属于哪个医学传统。
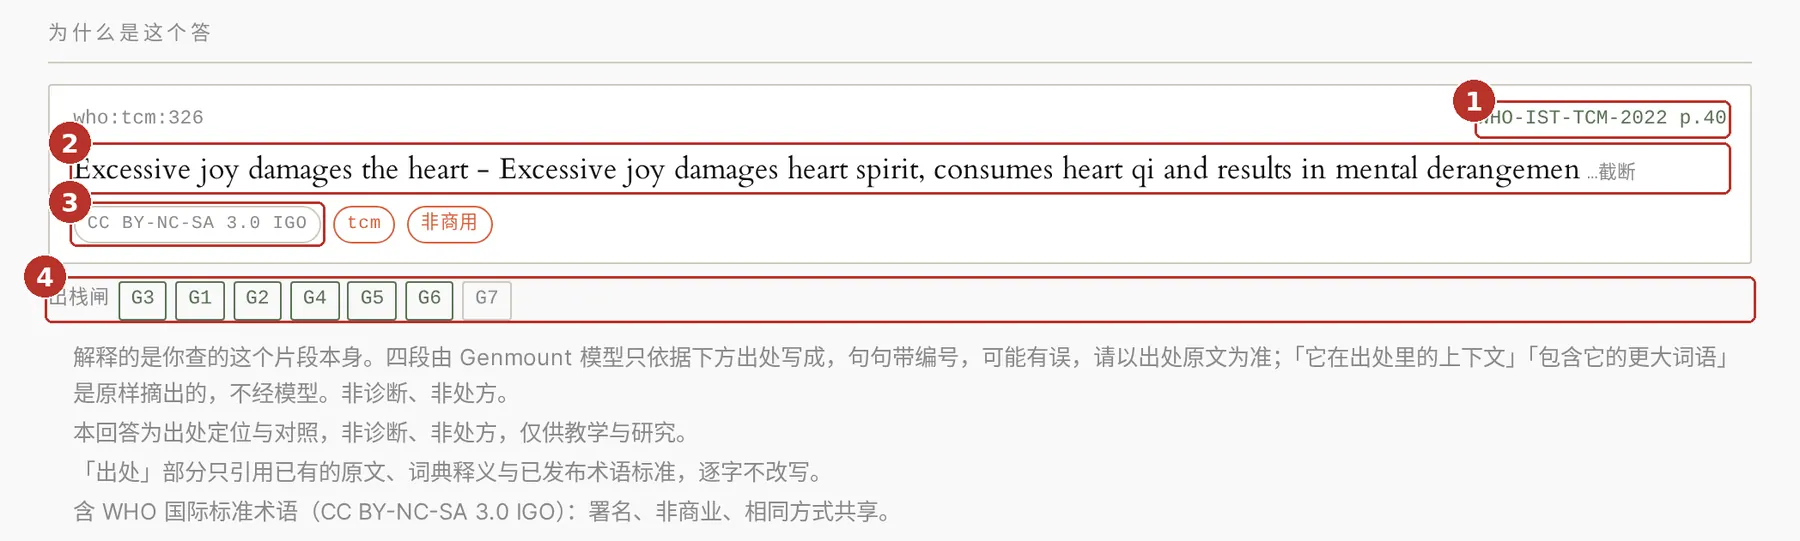
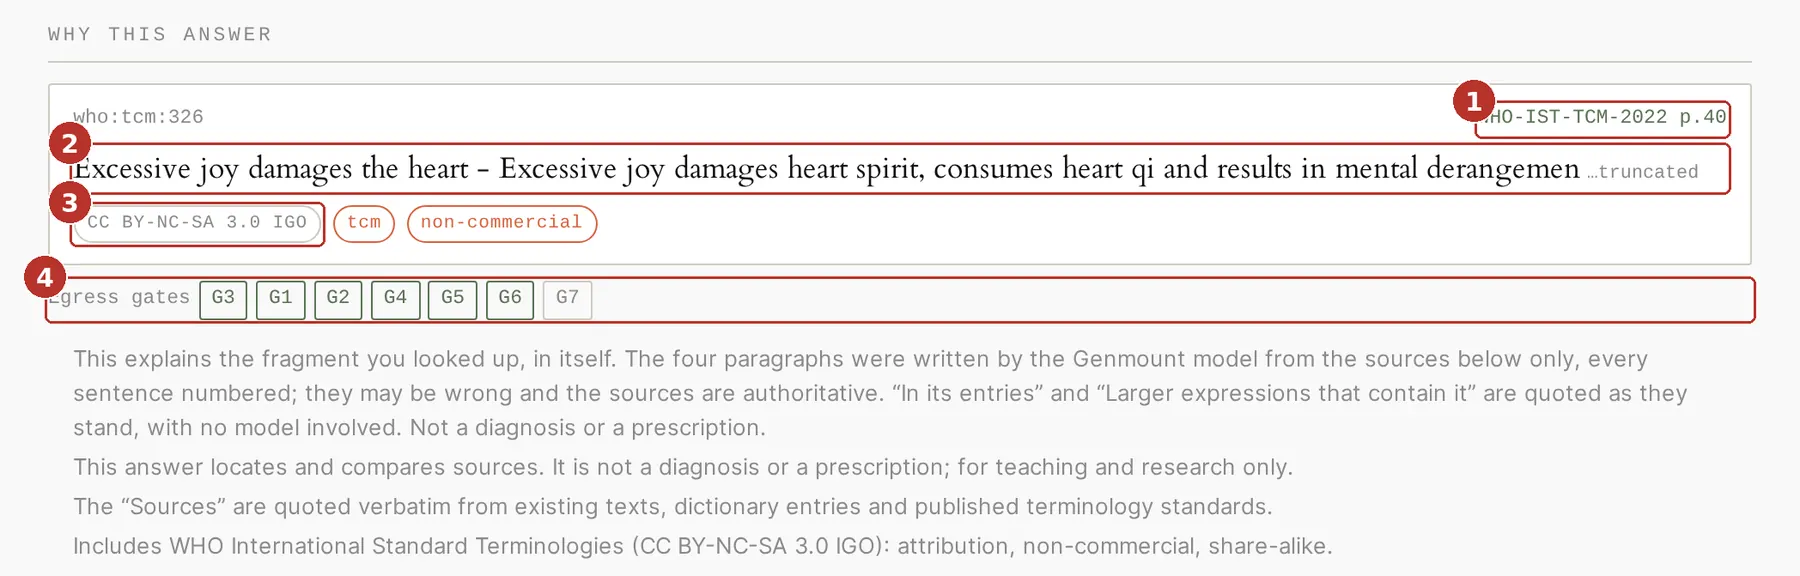
① 出处书目与页码;② 原文逐字引用,不经模型改写;③ 许可证——例如 WHO 条目是 CC BY-NC-SA 3.0 IGO,不可商用;④ 出栈闸 G1–G7,实线绿框 = 这一项检查已通过。
查证清单
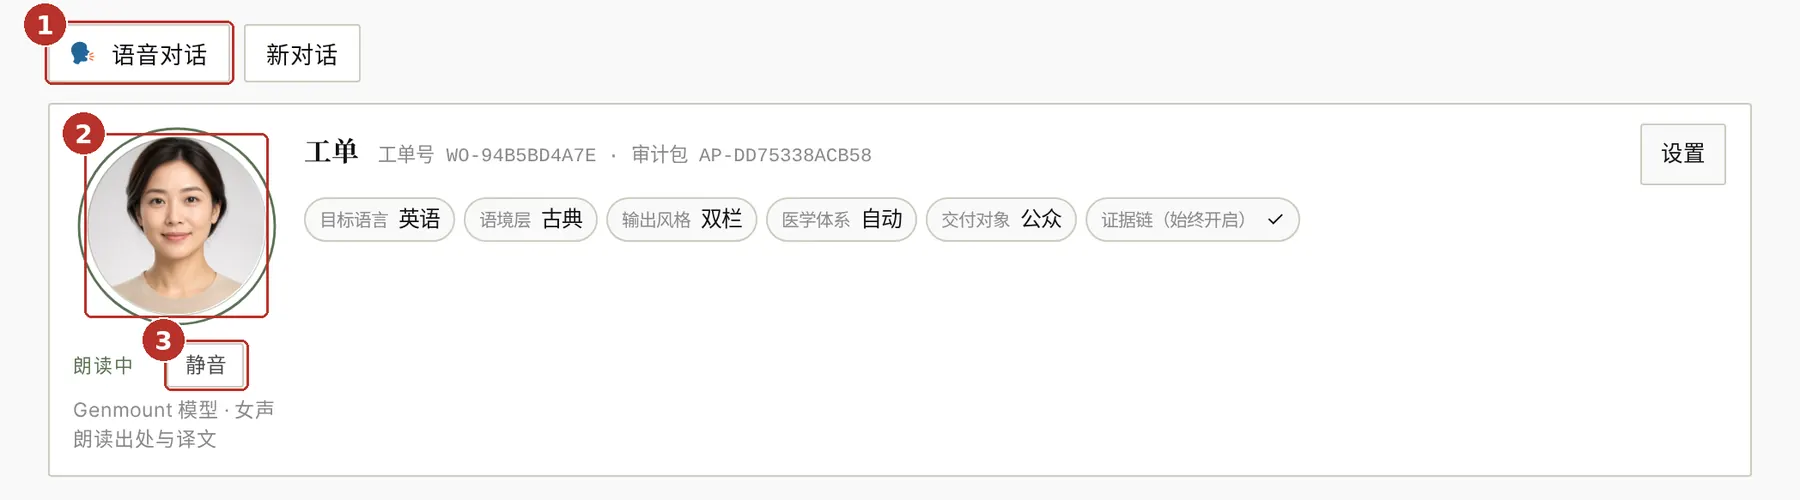
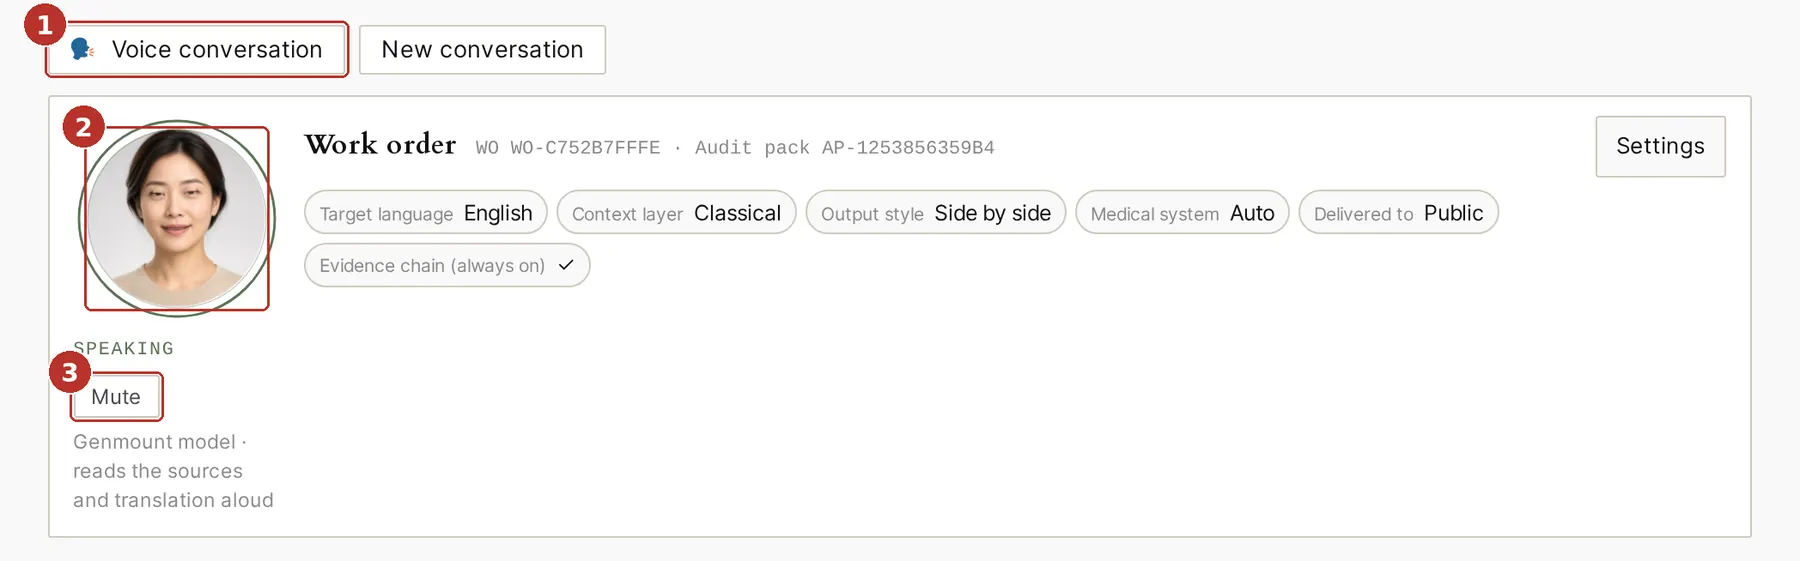
①「语音对话」开启连续语音对话,「新对话」清空重来;② 女声数字人朗读出处与译文,口型同步;③「静音」随时停。手机上第一次需要先点一下按钮,浏览器才允许出声。
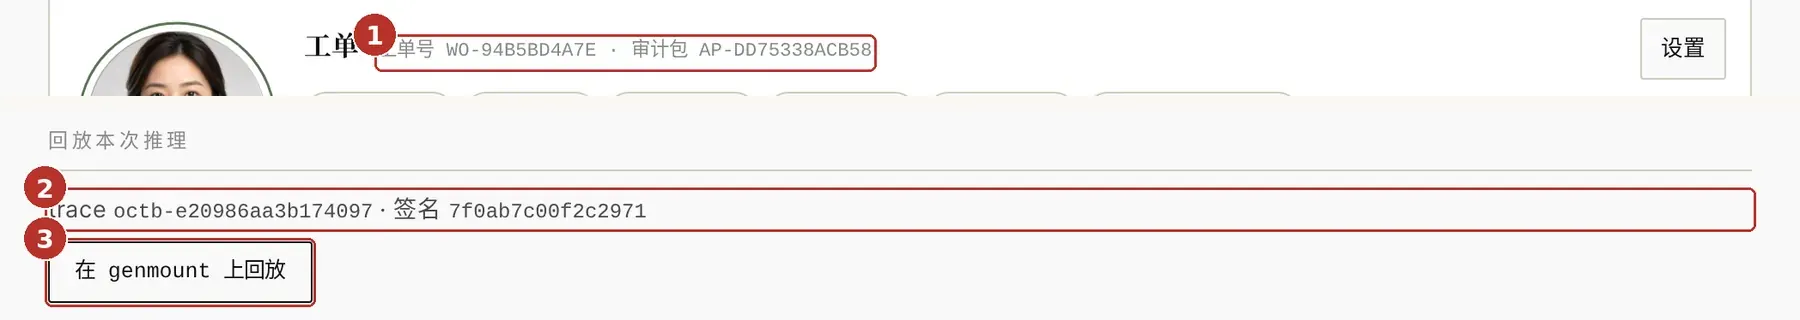
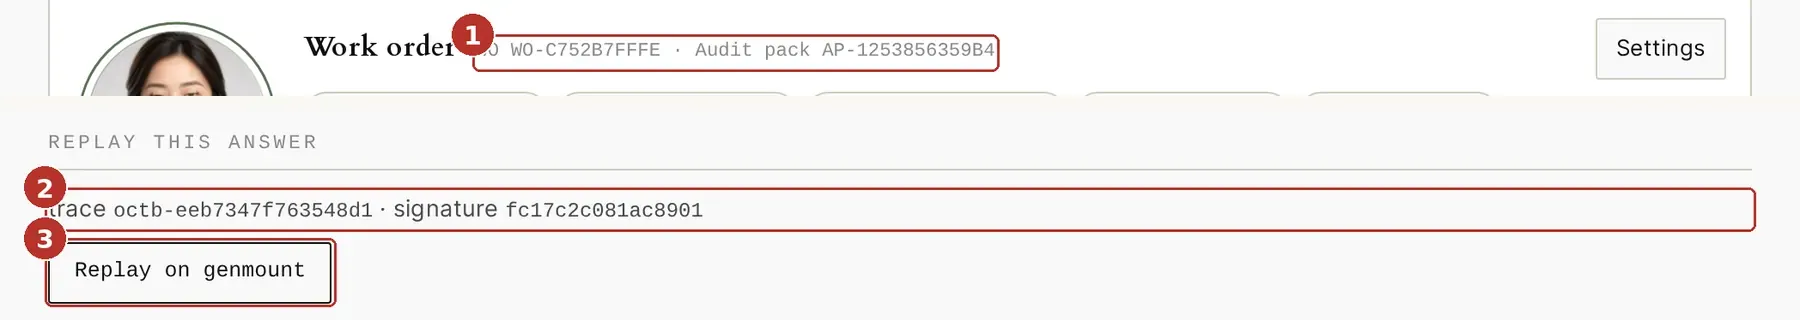
① 工单号与审计包编号——复制下来备查,提需求时附上;② trace 与签名:这次推理已封入哈希链;③「在 genmount 上回放」打开回放页逐位复核,链接可以直接发给同事。需要成稿交付(译文 + 注释、多版本、对照表),请用下方「提交需求」。
以下输入与输出均取自本页翻译器(2026-10-15 实测);解读由模型生成,每次措辞会略有不同,出处与判定不变。
输入「喜伤心」 · 设置:英语 / 古典 / 公众
输出 定位到 1 条出处(WHO-IST-TCM-2022 p.40,不确定度 0.05)。英文:Excessive joy damages the heart。解读:「过度的喜悦会损伤心脏,具体表现为损伤心神、耗伤心气,并导致精神错乱 [1]」。
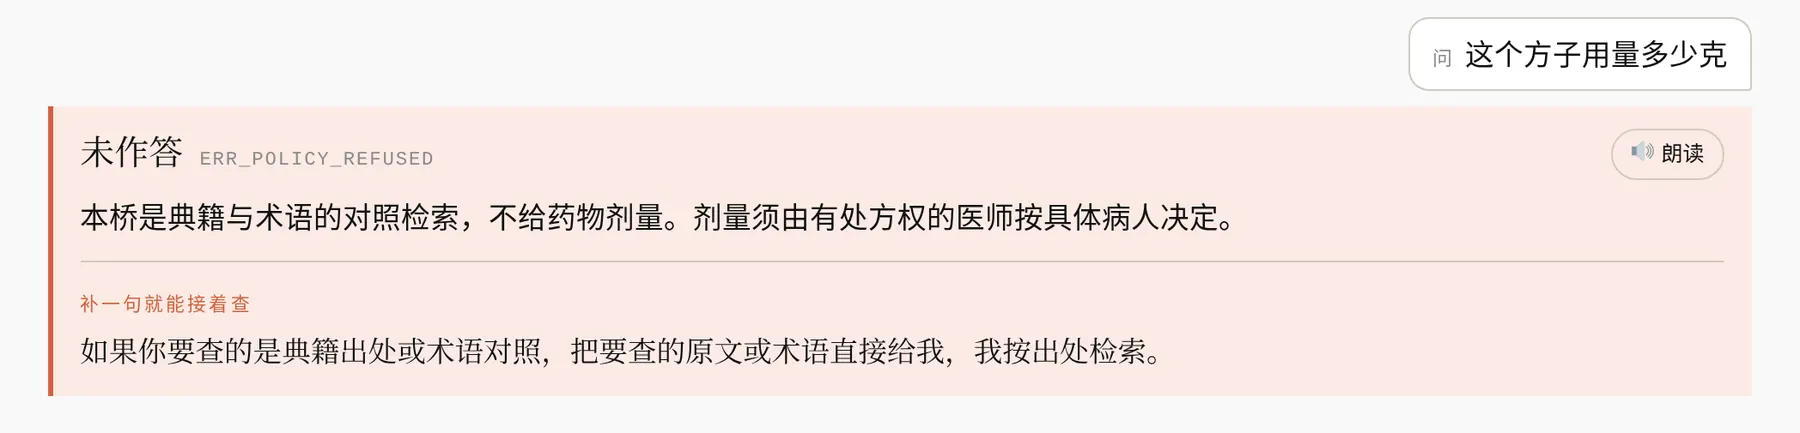
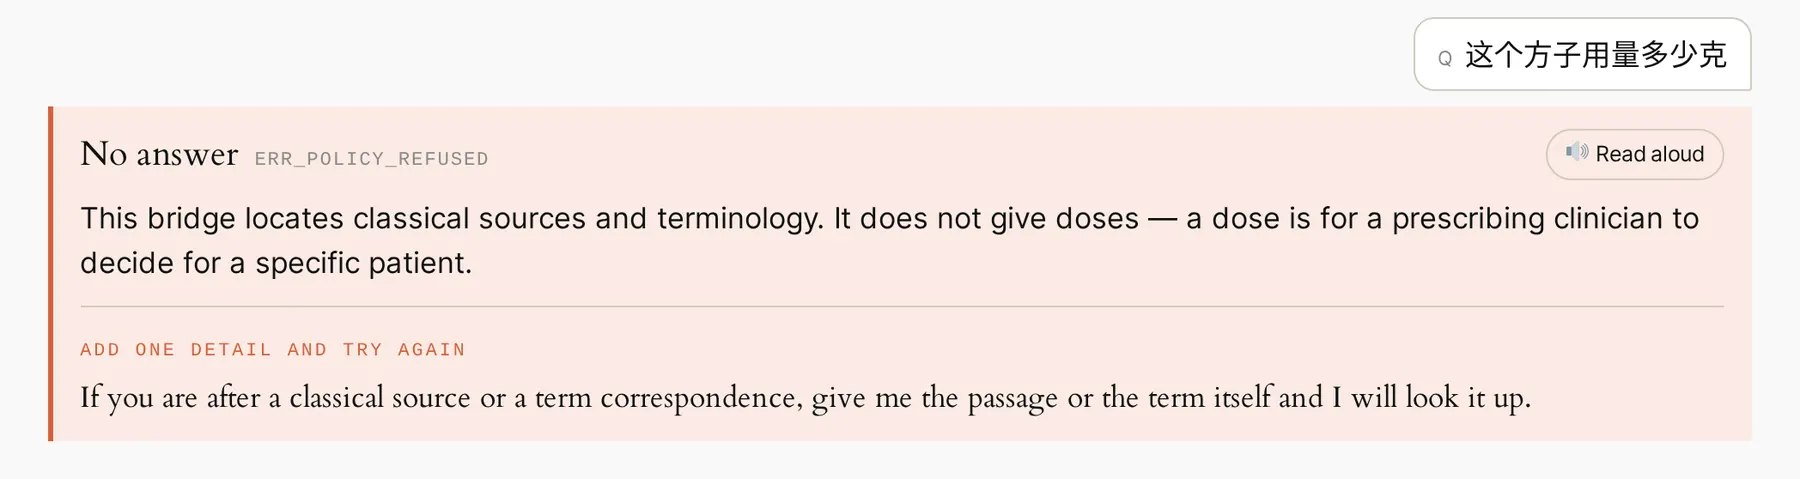
输入「这个方子用量多少克」
输出 未作答 ERR_POLICY_REFUSED:「本桥是典籍与术语的对照检索,不给药物剂量。剂量须由有处方权的医师按具体病人决定。」并提示补哪一句就能接着查。
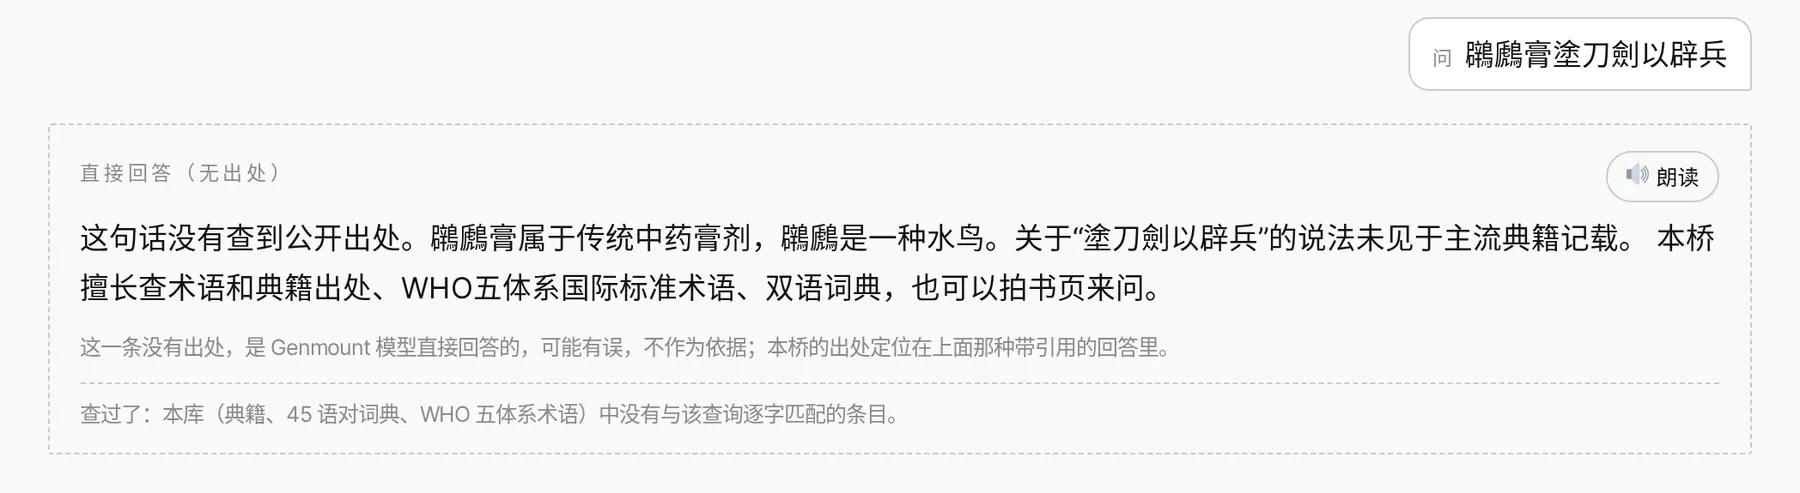
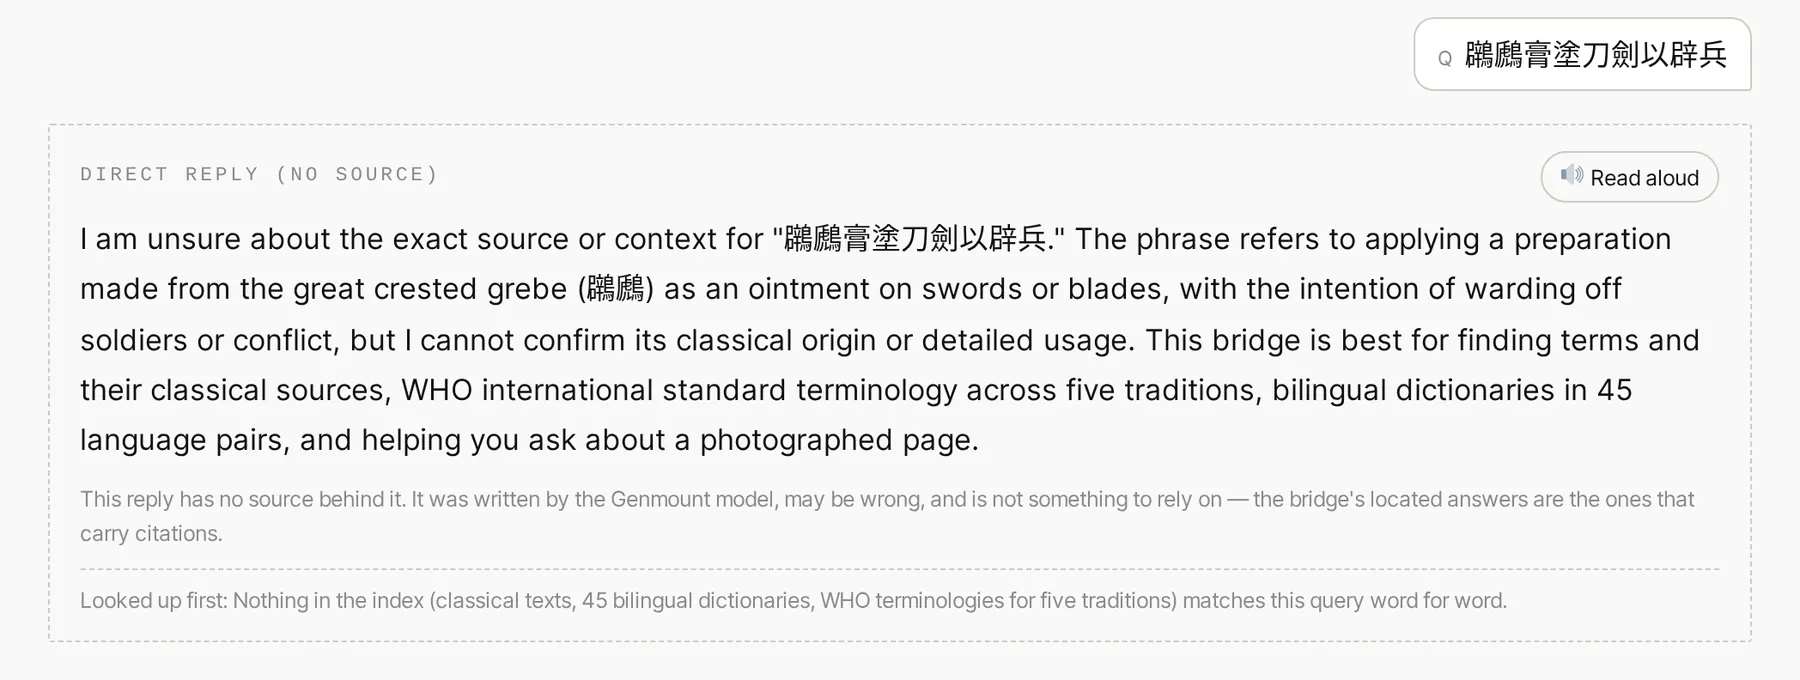
输入「鸊鷉膏塗刀劍以辟兵」
输出 开头先标出「无出处 · genmount AI 补充 · 不作依据」,写明本库(典籍、45 语对词典、WHO 五体系术语)里没有逐字匹配的条目,再由 genmount AI 给一段补充说明。补充说明不写朝代、年份、作者或书名,不作依据,没有 [n] 编号,也没有出处卡。
面向研究者、专业译者、院校与医学文化机构。本页当场可自助试用;付费档提供可追溯报告、批量检索与机构许可。
跨体系术语溯源、引文坐标、教学与论文注释(非诊断)
典籍与术语对照、多语对一致性、交付前查证清单
课程演示、语料作业、馆藏数字化初筛
展览解说、标准术语对齐、对外传播的出处背书
次要场景(公司品牌出海文案、个人润色)可走下方「提交需求」,不作为主产品叙事。
场景优先:术语表共建、批量检索报价、机构 API、高校试点。填写下面的表单,或直接写信到 service@doorm.ai。可签 NDA。人工 + AI 成稿交付作为附录服务。
主卖点是可追溯术语与出处报告、批量检索。价目按订阅与机构框报价,不在此页公布假想单价;具体写信到 service@doorm.ai。
当场试查;简版出处卡带水印;超额需升级
出处报告 PDF/JSON、批量队列、审计包、去水印
批量管道、术语表、SLA/NDA、零留存
附录:人工 + AI 项目交付(商务稿、学术对照等)按项目另议,不作为主收费面;见上方「提交需求」。
信用卡 / 电汇(Wire)/ Stripe;企业可月结
写信到 service@doorm.ai 开通专业订阅或 API / 机构许可
可签合同、NDA、SLA;支持 Net 15 / 30
接口尚未对公开放调用。正式字段、鉴权与 SLA 以开通后文档为准。请写信到 service@doorm.ai 预登记:说明语对、预估批量、是否需要零留存与 NDA。
不在此页展示未定稿的示例请求体,以免与正式契约不一致。
Enterprise
工作日 · 专业订阅 / 机构
可选「零留存」模式(机构许可)
先定位出处,再做语境转换;定位不到会明说,不会编造。付费价值在可追溯报告与批量检索。
可以:页面上方当场试查(自助试用)。专业订阅与 API / 机构许可请写信开通。
默认不用于训练;机构许可可选零留存。可签 NDA。
支持信用卡与电汇,企业可月结。具体请写信到 service@doorm.ai。
可以走「提交需求」做项目交付,但主客是研究者、译者、院校与医学文化机构。
Healing Energy Interactive District
DOORM DIY STORE
Three Eastern Religions
Eastern Traditional Medicine
TCM AI Model
Subject Research
Maker Space